python3的学习
python3的学习
目录
- []
第一章:基础语法
- 第一个字符必须以字母(a-z, A-Z)或下划线 _ 。
- 标识符的其他的部分由字母、数字和下划线组成。
- 标识符对大小写敏感,count 和 Count 是不同的标识符。
- 标识符对长度无硬性限制,但建议保持简洁(一般不超过 20 个字符)
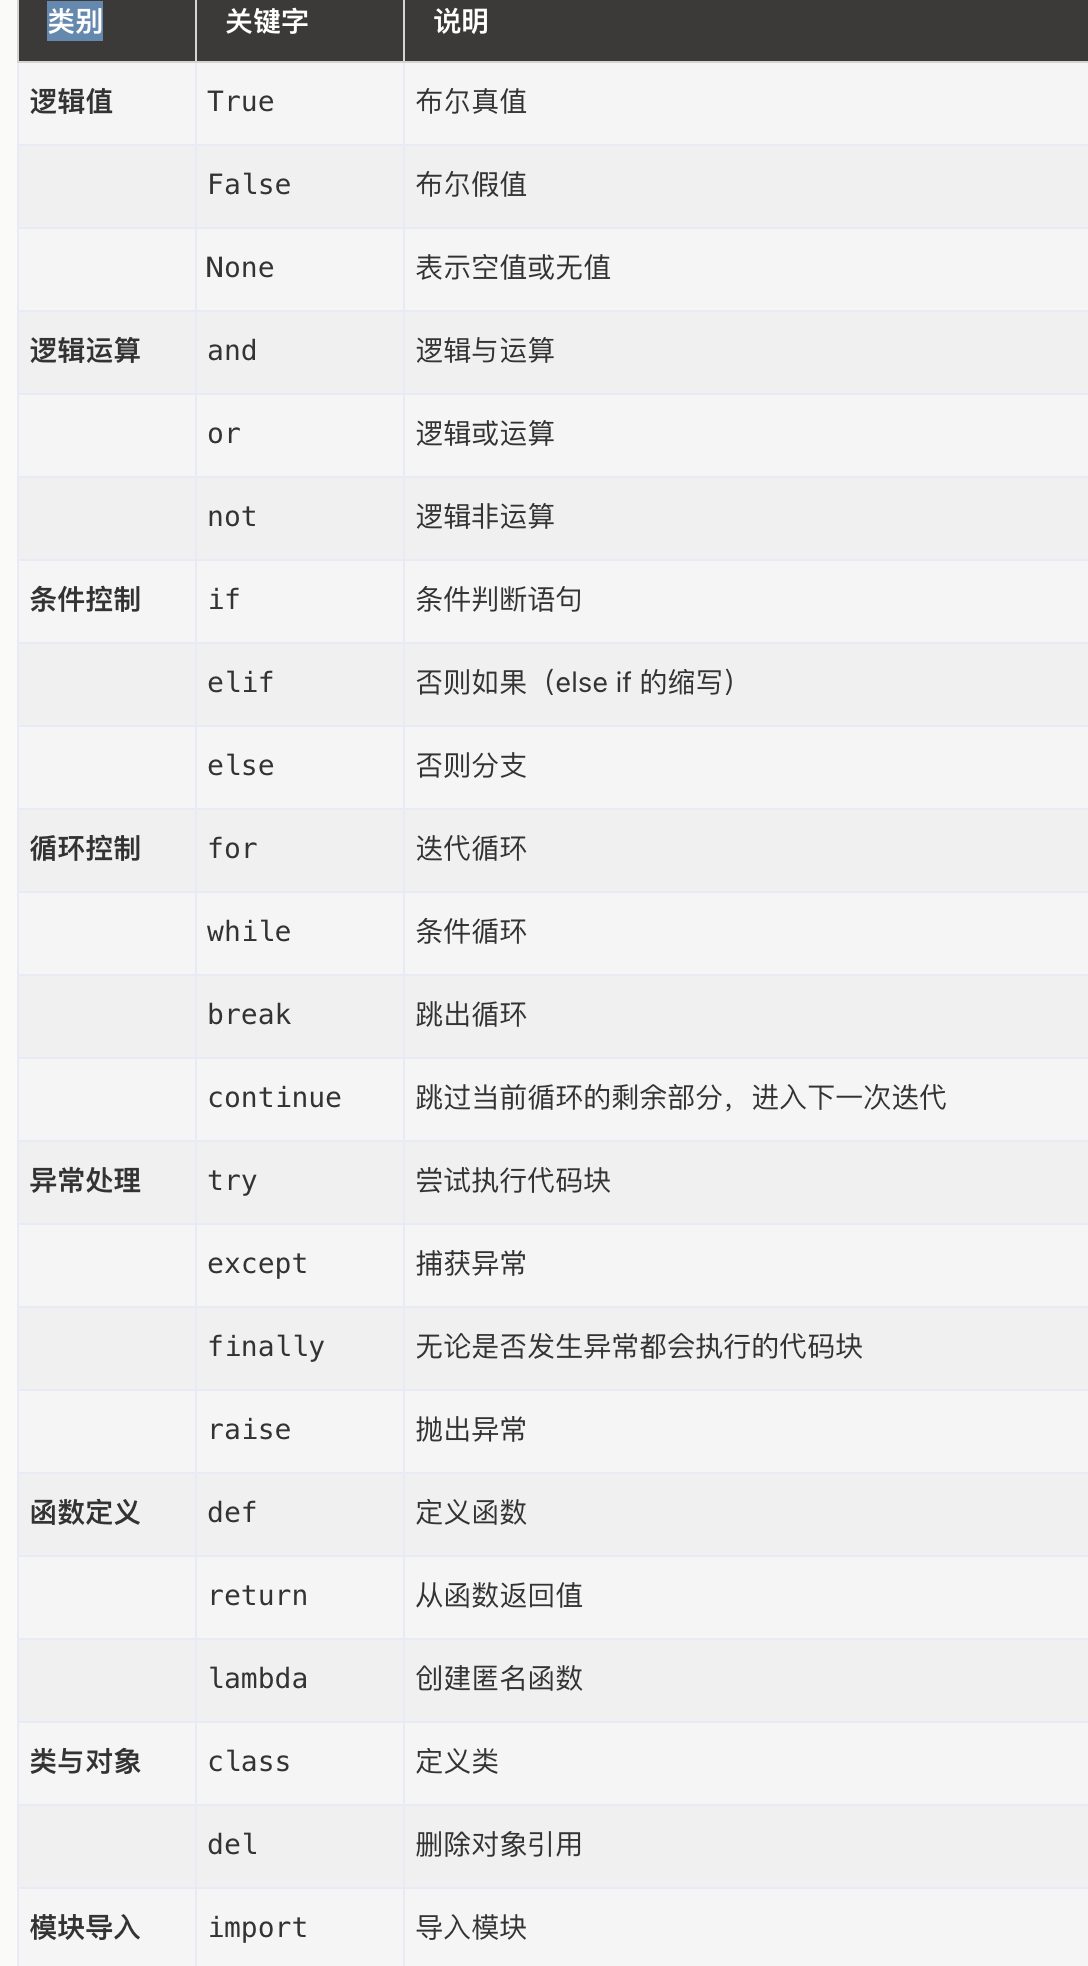
- 禁止使用保留关键字,如 if、for、class 等不能作为标识符。
==eg==.
1 | age = 25 # 普通变量名,最常见 |
1 | 2nd_place = "silver" # 错误:以数字开头 |
==⚠️==:Python 3 允许使用 Unicode 字符作为标识符,可以用中文作为变量名,非 ASCII 标识符也是允许的了
- 单行注释以 # 开头:
print ("Hello, Python!") # 第二个注释 - 多行注释可以用多个 # 号,还有 ‘’’ 和 “””:
1 | 第三注释 |
python最具特色的就是使用缩进来表示代码块,不需要使用大括号 {} 。
缩进的空格数是可变的,但是同一个代码块的语句必须包含相同的缩进空格数。空格数不一致,会导致运行错误。==4个空格为一个缩进==
空行的作用在于分隔两段不同功能或含义的代码,便于日后代码的维护或重构。
print 默认输出是换行的,如果要实现不换行需要在变量末尾加上 end=” “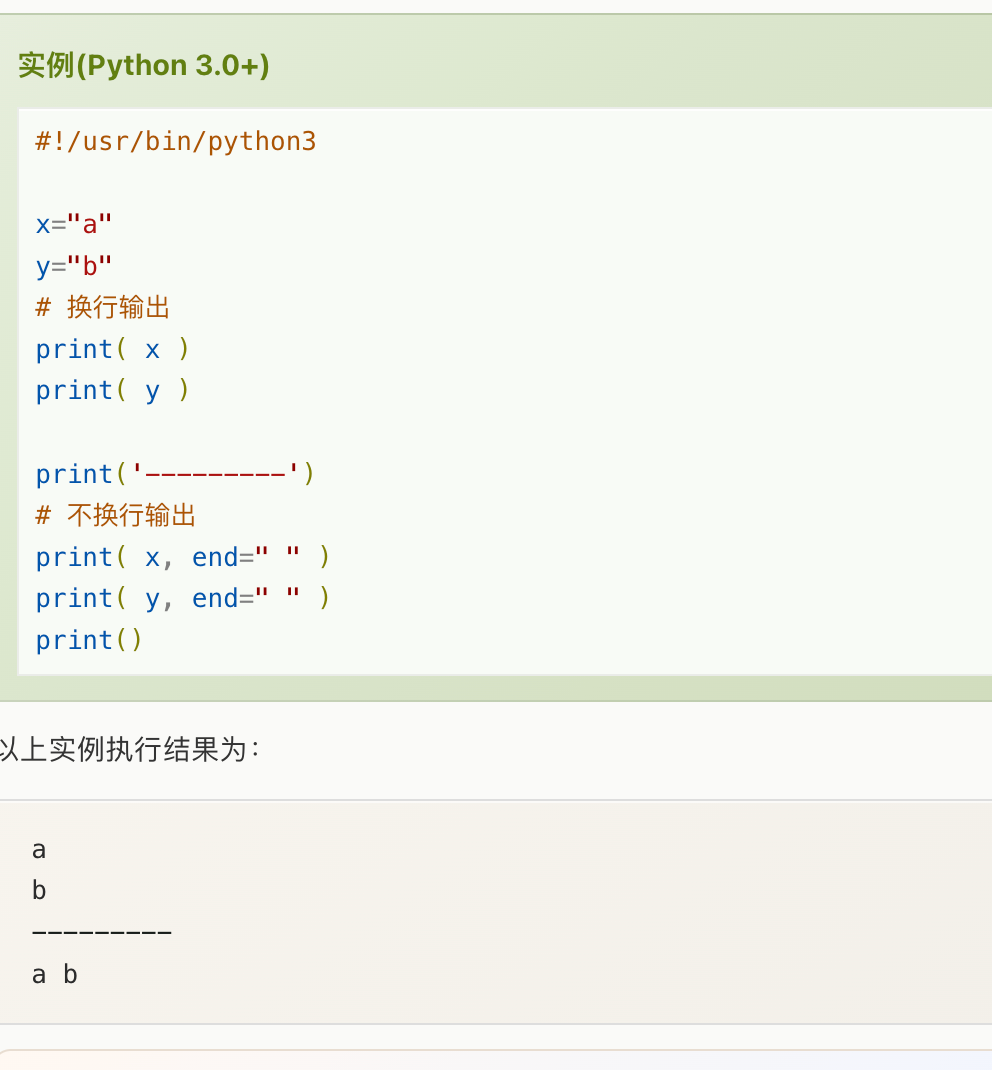
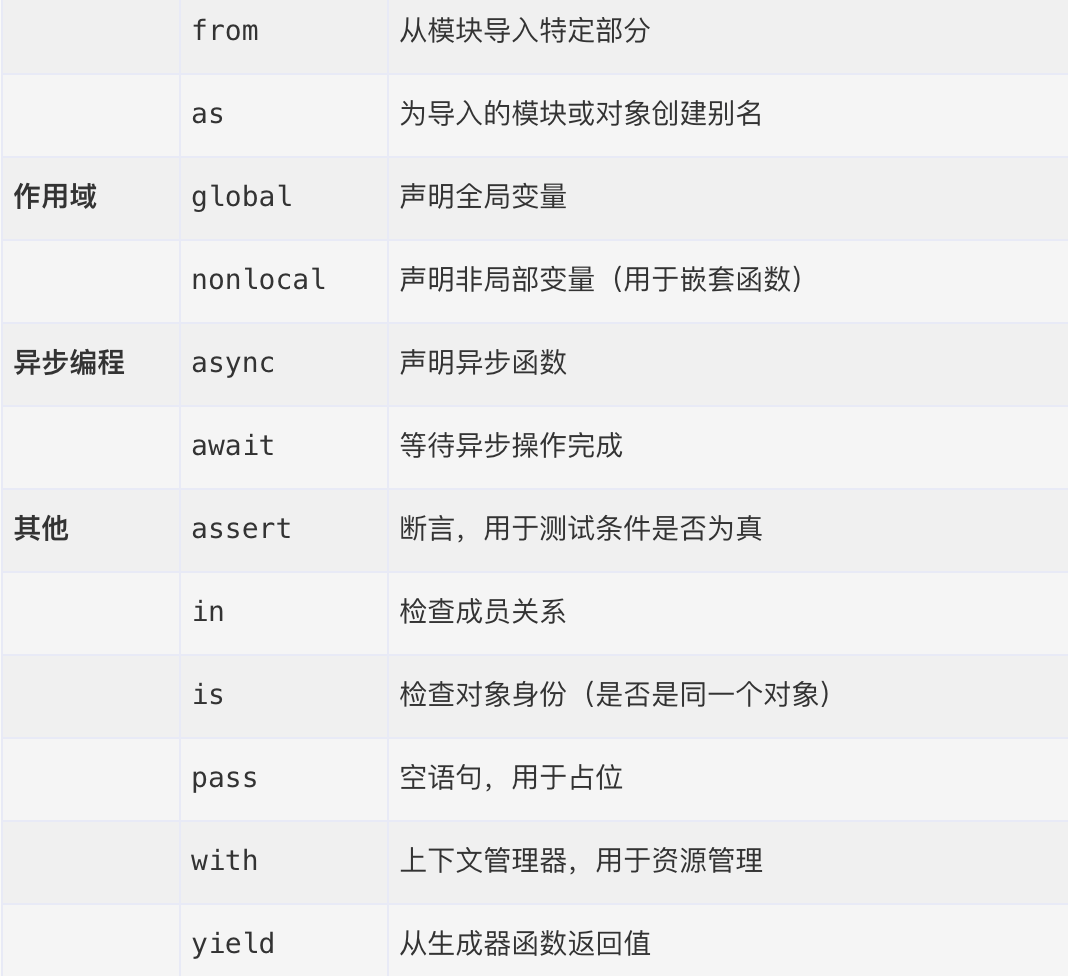
在 python 用import或者 from...import 来导入相应的模块[^模块]。
将整个模块(somemodule)导入,格式为: import somemodule
从某个模块中导入某个函数,格式为: from somemodule import somefunction
从某个模块中导入多个函数,格式为: from somemodule import firstfunc, secondfunc, thirdfunc
将某个模块中的全部函数导入,格式为: from somemodule import *
[^模块]: 模块就是一个 .py 后缀的 Python 文件,里面写好了变量、函数、类,用来把代码拆分、复用。
一句话:一个.py文件 = 一个模块.
怎么说呢,现在不是很理解这个东西,我对他现在的理解就是我可以从从终端里输入python3 test.py -n RUNOOB -u www.runoob.com这个东西,然后吧命令参数RUNOOB和www.runoob交给我的程序test.py
对了,命令行参数的内容都被保存在sys.argv这个模块中
以后我会回来补充的😘
基本数据类型
- Python 中的变量不需要声明。每个变量在使用前都必须赋值,变量赋值以后该变量才会被创建。
在 Python 中,变量就是变量,它没有类型,我们所说的类型是变量所指的内存中对象的类型。
等号 = 用来给变量赋值。等号左边是变量名,右边是存储在变量中的值。
==eg==:
1 | #!/usr/bin/python3 |
- Python 允许你同时为多个变量赋值。
==eg==:a = b = c = 1ora, b, c = 1, 2, "runoob" - 可以通过
type()函数查看变量的类型
==like==:
1 | print(type(x)) # <class 'int'> |
标准数据类型
Python3 中有 6 种标准数据类型,以及 bool 布尔类型(bool 是 int 的子类,有时单独列出):
- Number(数字):int、float、bool、complex(复数)
String(字符串):Python 中的字符串用单引号'或双引号"括起来,同时使用反斜杠\转义特殊字符。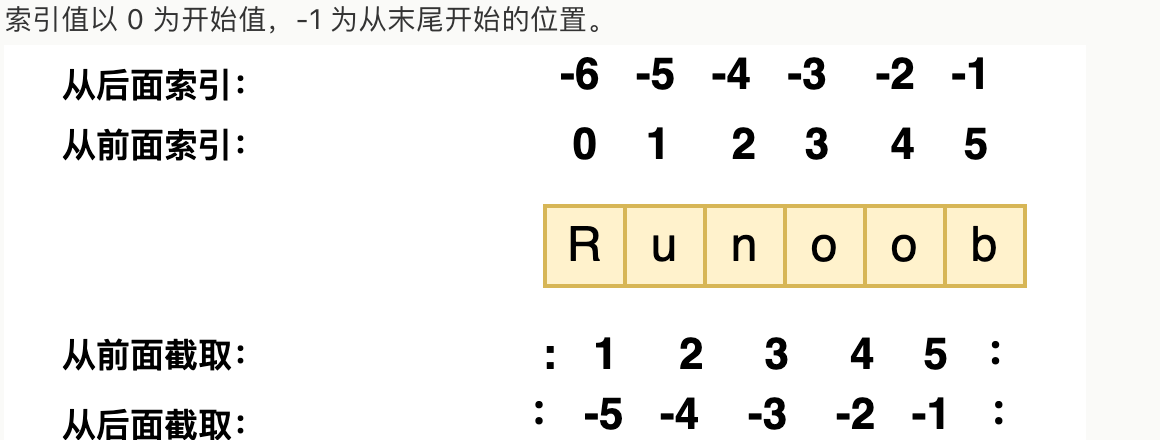
1 | #!/usr/bin/python3 |
输出
1 | Runoob |
Python 使用反斜杠 \ 转义特殊字符,如果你不想让反斜杠发生转义,可以在字符串前面添加一个 r,表示原始字符串:
1 | >>> print('Ru\noob') |
bool(布尔类型):布尔类型即 True 或 False。在 Python 中,True 和 False 都是关键字,表示布尔值。
List(列表):列表写在方括号 [] 之间,用逗号分隔开的元素列表。
语法格式:变量[头下标:尾下标]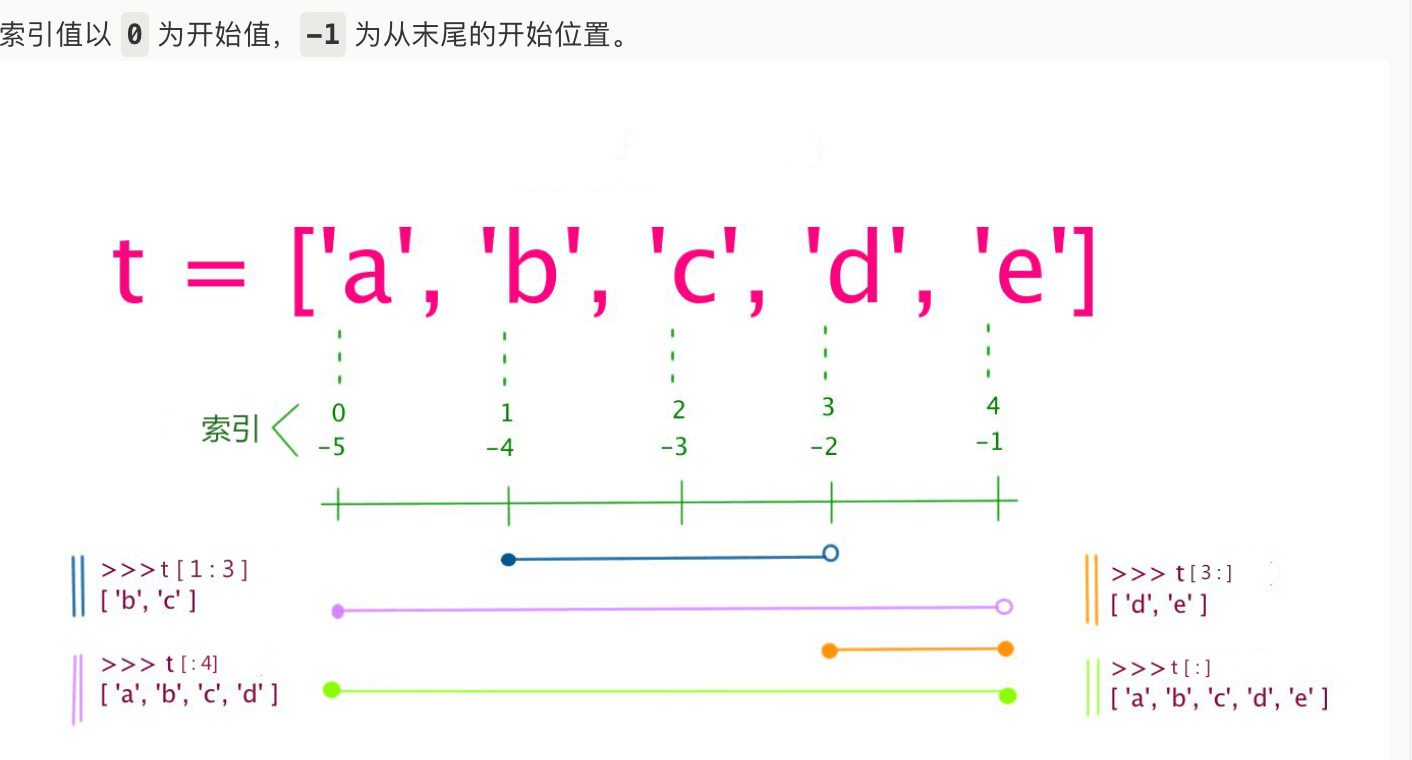
和字符串一样,列表同样可以被索引和截取,列表被截取后返回一个包含所需元素的新列表
Tuple(元组):元组(tuple)与列表类似,不同之处在于元组的元素不能修改。元组写在小括号 () 里,元素之间用逗号隔开。
Set(集合):Python 中的集合(Set)是一种无序、可变的数据类型,用于存储唯一的元素。集合中的元素不会重复,并且可以进行交集、并集、差集等常见的集合操作。
在 Python 中,集合使用大括号 {} 表示,元素之间用逗号 , 分隔。也可以使用 set() 函数创建集合。
==注意==:创建一个空集合必须用 set() 而不是 {},因为 {} 创建的是一个空字典。
Dictionary(字典)
按是否可变,可以分为以下两类:
不可变数据(4 个):Number(数字)、String(字符串)、bool(布尔)、Tuple(元组)
可变数据(3 个):List(列表)、Dictionary(字典)、Set(集合)
bytes 类型表示的是不可变的二进制序列(byte sequence)。与字符串类型不同的是,bytes 类型中的元素是整数值(0 到 255 之间的整数),而不是 Unicode 字符。
bytes 类型:
bytes 类型通常用于处理二进制数据,比如图像文件、音频文件、视频文件等。在网络编程中,也经常使用 bytes 类型来传输二进制数据。
创建 bytes 对象最常见的方式是使用 b 前缀:
1 | x = b"hello" # 使用 b 前缀创建 bytes 对象 |
数据类型的转换
- 隐式类型转换-自动完成:
对两种不同类型的数据进行运算,较低数据类型(整数)就会转换为较高数据类型(浮点数)以避免数据丢失。但是整型和字符串类型运算结果会报错。 - 显式类型转换-需要使用类型函数来转换
==eg==:y = int(2.8) # y 输出结果为 2
头歌实验:
- 补齐空格:
ljust(左对齐补齐空格)
1 | 'WHU'.ljust(4) # 'WHU ' ← 补到 4 个字符宽 |
- 必备参数:
def add(a, b): # ← 你在这里承诺:"用我,必须给我两个值" - return:return 的作用是”把值送出去”,”结束函数”只是顺带的后果。
- 什么时候真的需要 return
两种情况,一种是送值,一种是提前结束:
① 要把结果交给调用方
1 | def add(a, b): |
② 要提前溜走,跳过后面的代码
这才是你想的”退出函数”——但注意,只有当后面还有代码需要跳过时,它才有意义:
1 | def check(n): |
对比一下,return 在末尾和在中途的区别:
1 | def f(): |
return 写在最后一行 = 废话;写在中间 = 真的在”退出函数”。
- 变量输出:首先,我们先来分清“格式化”和”输出“:
- f”…”、”%s” % x、”{}”.format(x) → 都是造出一个新字符串,跟 print 没关系
- print() → 才是把东西显示到屏幕上
有五种写法:
1 | name = "李明" |
逐个说:
1 |
|
==注意==: 多个值要用元组包起来。 一个值时圆括号可省,两个以上必须加:
1 | print("%s" % name) # ✓ 一个值,可以省 |
1 | ④ str.format()——过渡方案 |
- print:
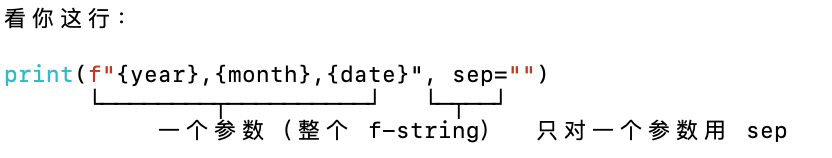
1 | print("a", "b", "c") # a b c 默认用空格分隔 |
- 嵌套函数:
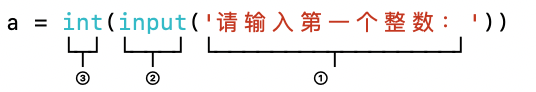
拆解:从里往外读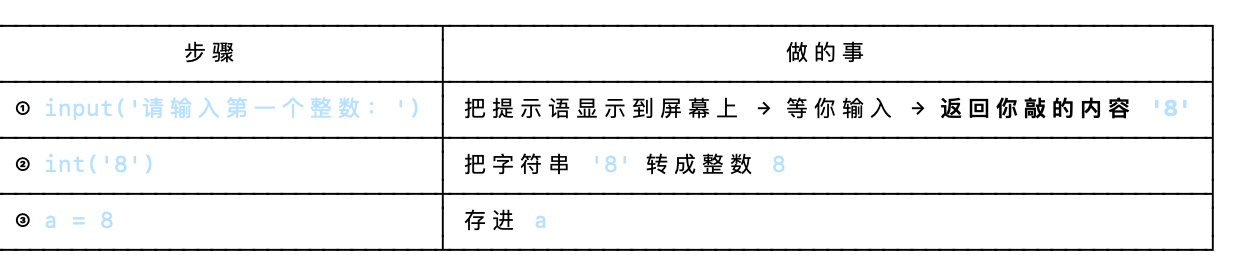
- 亲眼看看 eval 到底有多”万能”
1 | print(eval("2 + 3")) # 5 |
普通字符串:一张纸条,上面写着算式,只给你看文字
eval(把字符串当代码执行):叫 Python读纸条上的内容,直接算出答案,input()*10 # 这本身就是一段合法的 Python 代码
input只执行字符串- if语法:
- 冒号 : = 宣告”下面是一个代码块”
- 缩进 = 标记”这几行属于这个代码块”,缩进的规矩:统一用 4 个空格
- 格式说明符里不能写变量名
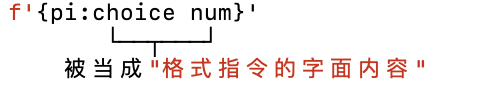
关键认识:冒号后面那段是「格式语言」,不是 Python 表达式。
你在里面写 choice,Python 不会去查这个变量的值,而是把它当成格式指令去解析。choice num 不是合法的格式指令 → 报错。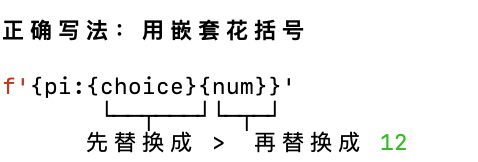
- 「截取」and「四舍五入」
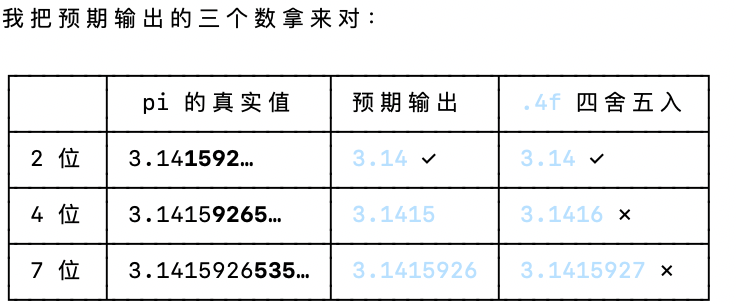
.4f这种写法是四舍五入,字符串切片天生就是”截取”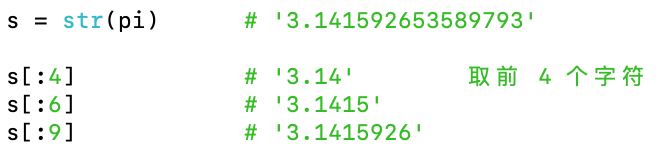
- 嵌套引号
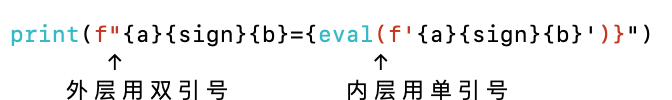
- random模块用法
导入
1 | import random |
常用函数一览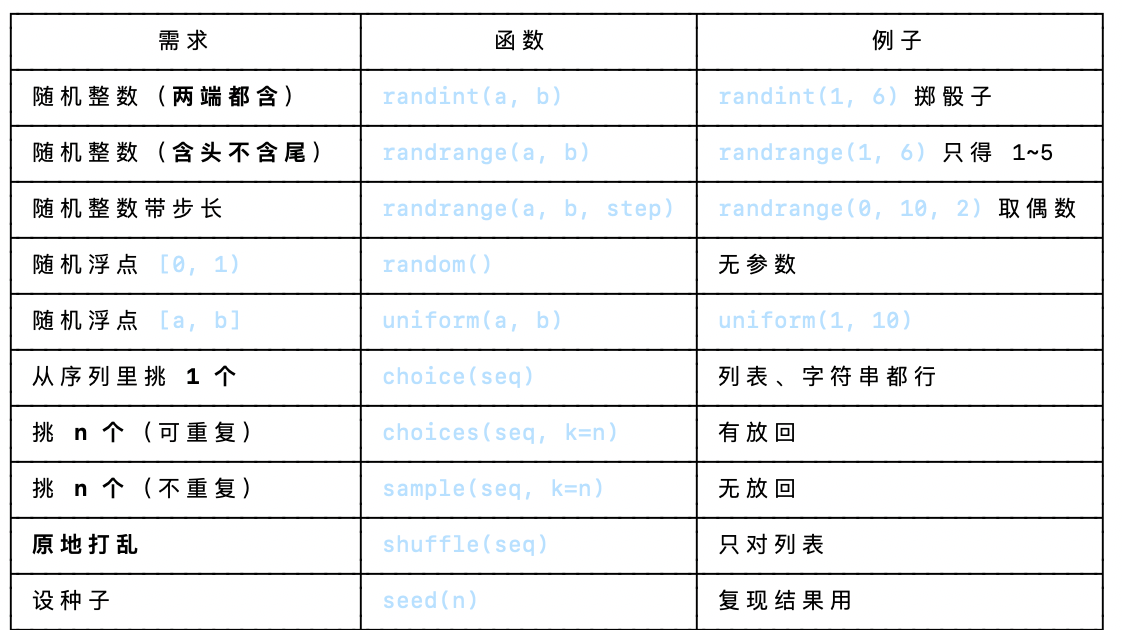
实测效果(我跑出来的真实输出):
1 | random.randint(1, 6) # 6, 1, 1, 6, 3, 2, 2, 2, 6, 1 |
==坑点==:
shuffle 原地改,返回 None
1 | lst = [1, 2, 3, 4, 5] |
seed 有什么用:
1 | random.seed(1) |
不设种子时,Python 拿系统时间当种子,所以每次跑结果都不同。设了种子,同一串随机数就能反复重现。相当于固定了翻书起点,数字组合会变,但是产生这个组合的方式不变。
三个实际用途:
- 调试 —— 程序在某个随机情况下出错,固定种子就能每次都重现那个 bug,否则你根本抓不住
- 出题/判题 —— 头歌这类平台的”随机”测试数据必须可复现,否则没法判分
- 做实验 —— 对比两种算法时,要让它们面对同一批随机数据才公平
- 字符串,列表,元组,字典
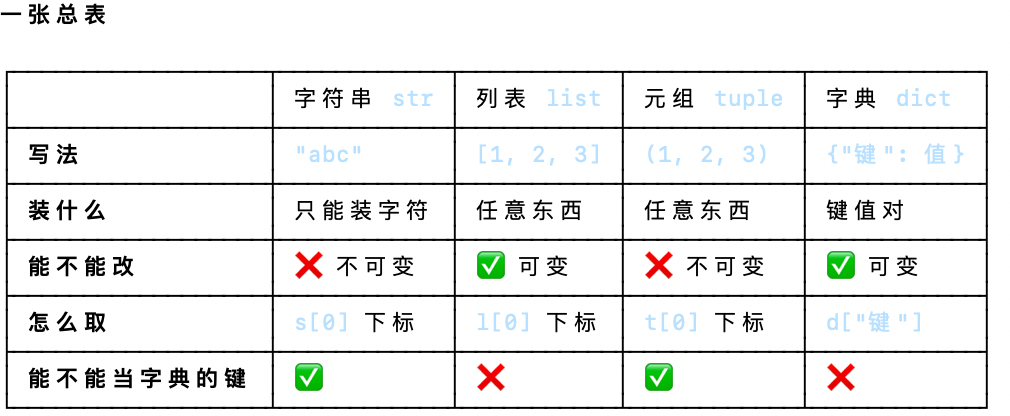
键(key)和值(value)
{“键”: 值} 是JSON 格式,Python 里对应的叫字典 dict,整体是一对一对的映射关系:
键(key):索引、名字,用来查找- 一般是字符串(要用引号包起来),也可以是数字
- 同一个字典里键不能重复,重复会被覆盖
- 作用:你通过键去找对应的数据
值(value):真正存的数据 - 可以是:文字、数字、true/false、数组[],甚至另一个{}对象
- 值可以重复,没有限制
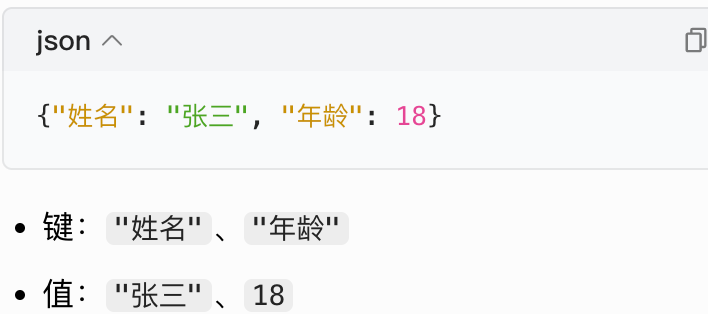
第一条分界线(最重要):能不能改
不可变:字符串 元组 ← 造出来就冻住了
可变 :列表 字典 ← 可以增删改
第二条分界线:靠什么取元素
靠位置(下标):字符串 列表 元组 ← 第 0 个、第 1 个……
靠名字(键) :字典 ← d[“age”]
1.字符串 str:处理文字、用户输入、文件内容。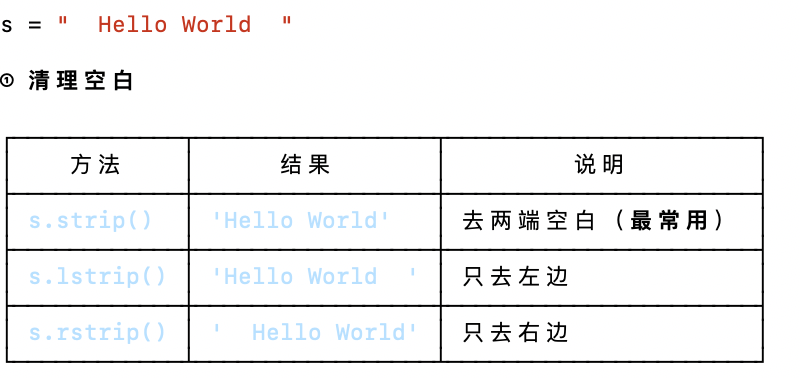
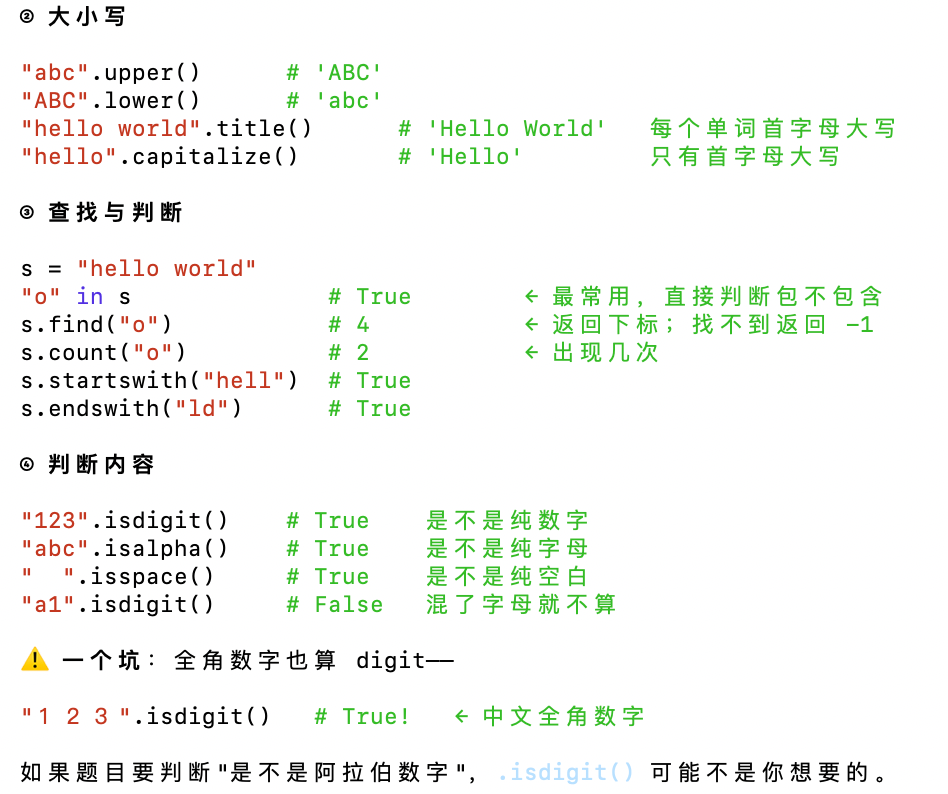
2.列表 list:你最常用到的:有序、可变、什么都能装。 就是”C 里那个你得自己 malloc 的动态数组”。
1 | scores = [85, 92, 78] |
3.元组 tuple——列表的”冻结版”:数据天生就不该被改时:
坐标 = (3, 4)
RGB颜色 = (255, 128, 0)
日期 = (2026, 10, 8)
元组的隐藏技能:解包
1 | name, age = ("张三", 19) # 一次拆成两个变量 |
顺带:a = 1, 2 其实就是在造元组(括号可以省)。赋值号右边有逗号,就是元组。
4.字典 dict——用”名字”查东西
1 | student = {"name": "张三", "age": 19, "city": "武汉"} |
拿不准键在不在时,用 get()。
1 | student["zzz"] # ✗ KeyError:键不存在直接报错 |
互换:
1 | list("abc") # ['a', 'b', 'c'] 字符串 → 列表 |
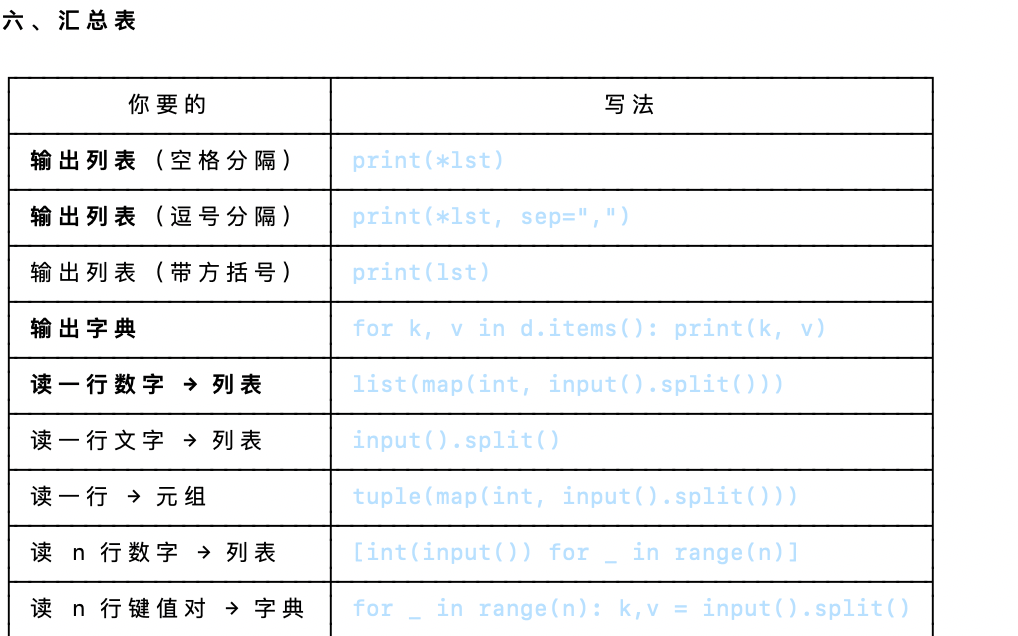
输入输出列表,元组,字典
- 输出
列表
1 | lst = [1, 2, 3] |
元组
1 | t = (1, 2, 3) |
字典(有个坑)
1 | d = {"a": 1, "b": 2} |
*到底是什么
你之前学 *args 时见过它——* 的作用是”把容器拆开”:
1 | print(*[1, 2, 3]) # 完全等于 print(1, 2, 3) |
这就解释了为什么它能去掉方括号——因为列表被拆成了三个独立的参数,print 就按”多个参数”来对待了(用 sep 分隔)。
顺带一提,sep 会作用于所有参数之间,包括你写的文字:
print("前缀", *lst, sep=", ") # 前缀, 1, 2, 3 ← "前缀"后面也有分隔符
输入
先背下这一行nums = list(map(int, input().split()))
1 | input() → "1 2 3 4 5" 一整行文本 |
- 集合set(无序、不重复的容器):
- 怎么创建:
1 | s = {1, 2, 3} # 花括号 |
- 坑点:
1 | type({}) # dict ← 空字典! |
- 两个核心特性:
1 | ① 不重复——自动去重 |
- 常用操作:
1 | s = {1, 2, 3} |
- 集合的运算:
1 | a = {1, 2, 3, 4} |
- 什么时候用:
1 | ① 去重(最常用) |
循环语法
1.python中的for时遍历而非计数,C里的是计数循环Python 的 for 后面跟的不是条件,是一个「容器」:
1 | for x in [10, 20, 30]: # 把列表里的元素一个个拿出来,每次叫它 x |
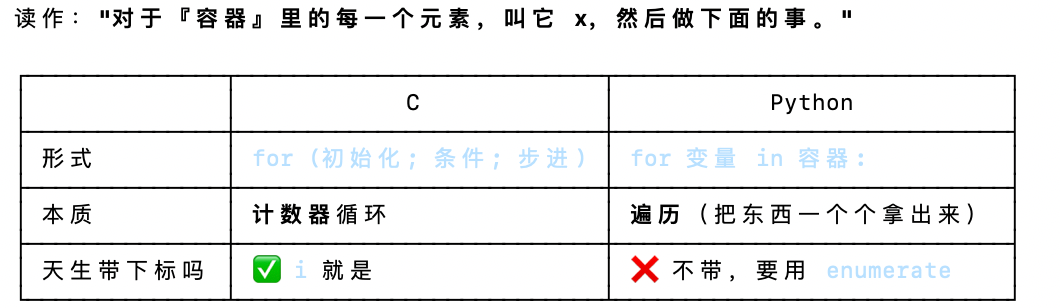
2.如果要计数的话,造一个数字序列去遍历它。range() 不是”计数器”,它造出一串数字让你去遍历:
1 | for i in range(10): |
range(5, 0) 那个坑要记牢:往回数必须写负步长,range(10, 0, -1) 才对。忘了写 -1 就得到空序列,for 一次都不执行,程序静悄悄地什么都不干。
▎ 含头不含尾这个规则你已经在切片里见过(s[1:4])——range 和切片用的是同一套规则,Python 里凡是”范围”都这样。
for 的循环变量是每次都重新赋值的:
1 | for i in range(3): |
(这点和 C 一样。)
3.for 能遍历什么
1 | for x in [1, 2, 3]: # 列表 |
for _ in range(n) 里的下划线是惯例:”这个变量我用不上,占个位”。你在 OJ 代码里见过很多次了。
4.while(先判断后执行):什么时候用 while 而不是 for?
▎ - 知道要跑多少次 → for
▎ - 不知道跑多少次,只知道”到某个条件就停” → while
比如”一直读输入直到读到 0 为止”,就该用 while。
5.for…else:Python 特有的
1 | for x in [1, 2, 3]: |
6.两个好搭档:enumerate 和 zip
enumerate:既要下标又要值
1 | C 的 for 天生带下标 i,Python 的 for 不带——所以需要下标时用 enumerate: |
zip:同时遍历多个序列
1 | names = ["张三", "李四", "王五"] |
C 里你得用同一下标 i 去访问两个数组,Python 直接 zip 起来。哪个短就以哪个为准,多出来的忽略。
7.一个必踩的坑:
1 | lst = [1, 2, 4, 6, 5] |
原因:for 是按位置依次取元素的。你一边删元素,列表一边变短,后面的元素整体往前挪——而 for 的下标还在往前走,于是刚挪过来的那个元素被跳过了。
正确做法:造一个新列表,别改原来的。
1 | lst = [1, 2, 4, 6, 5] |
▎ 规矩:遍历时不要增删容器元素。 要筛选用”造新列表”,非要原地删就倒着遍历(reversed)或者用 while 手动控制下标。
▎
▎ 注意:改元素的值是安全的(lst[i] = 99 没问题),危险的是增删(改变长度)。
8.列表推导式 [x for x in lst if x % 2 != 0]:
把满足条件的元素收集成新列表
1 | [x * 2 for x in [1, 2, 3]] # [2, 4, 6] 对每个元素做变换 |
相当于for 循环 + append
1 | result = [] |
- Python 规定:所有系统自带的特殊变量 / 方法,都用
__xxx__格式。这些又叫python里的魔法变量。
1.__name__(你刚学的,最重要)
作用:告诉你当前模块是以什么方式被加载的
直接运行这个文件:__name__ == "__main__"
被别的文件import导入:__name__ == 文件名
用途:用来写if __name__ == '__main__':,分离函数定义 和 测试代码。
函数写上面,测试代码放进 if 里面;导入模块时不会自动跑测试。
__doc__文档字符串
就是函数 / 类下面用三引号写的说明文字。
1 | python |
__file__
保存当前 py 文件的路径(在本地电脑有效,在线平台不一定支持)
1 | python |
- 类里面的
__init__(魔法方法,不是变量,但是长得一样)
1 | python |
__init__:创建对象的时候自动执行,用来初始化对象属性。
其他常见魔法(后面学习会遇到)__str__:打印对象的时候,控制输出什么文字__len__:调用len(对象)时自动执行
✅ 重点区分:魔法变量 vs 普通变量
普通变量:存业务数据,比如长宽、面积、a=3
魔法变量:存代码本身的信息(文件名字、模块信息、文档说明),描述代码自身。
⚠️ 重要提醒
不要自己随便创建 __xxx__ 名字,属于系统预留,容易冲突。自己写变量只用普通名字,比如length、volume。
魔法变量不用你手动赋值,Python 自动帮你生成。你只负责读取。
简单总结
普通变量 = 存计算的数据(长宽、面积)__xxx__魔法变量 = 存代码自己的信息(文件、模块、文档)
“魔法”的意思是不用动手调用,python在特定时机自动调用他
- try/except:
解决的是一个很实际的问题:程别一出就死掉。
- 先看没有它会怎样:
1 | age = int(input("你的年龄:")) |
程序当场死了,print 那行一行都不执行。 用户看到一堆红色报错,什么也干不了。
2. 基本语法:
1 | try: |
流程:Python 去跑 try 里的代码 → 一切正常就走完了;中途出错 → 立刻跳到 except,try 里剩下的代码不执行。
3. 完整结构:
1 | try: |
- 常用的错误类型:
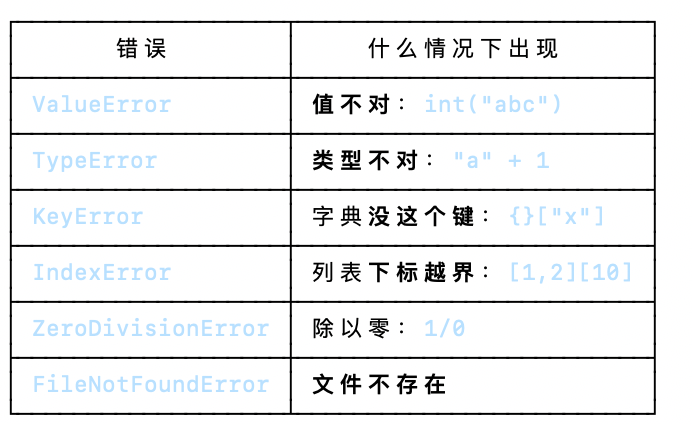
- 三条规矩:
1 | ① 别写光秃秃的 except: |
- 经典用法:
1 | 这是你最常用到的模式,背下来: |
流程:一直问 → 用户输入合法数字就 break 出去 → 不合法就提示重试。
这解决了你之前反复踩的那个坑:用户输入乱七八糟的东西,程序不再崩溃。
7. 什么时候该用、什么时候不该用:
- 用户输入(上面那个)
- 读文件(文件可能不存在)
- 网络请求(可能超时)
- 格式转换(数据可能不合预期)
❌ 不该用来掩盖自己的 bug
try:
复杂的一段逻辑
except Exception:
print(“出错了”)
这种写法很危险:它把你代码里的真实错误也一起吞了。你写错的变量名、用错的方法,全都会被伪装成”出错了”,然后你永远查不出来。
判断标准一句话:
▎ try/except 是给”我控制不了的意外”用的,不是给”我没写对”用的。
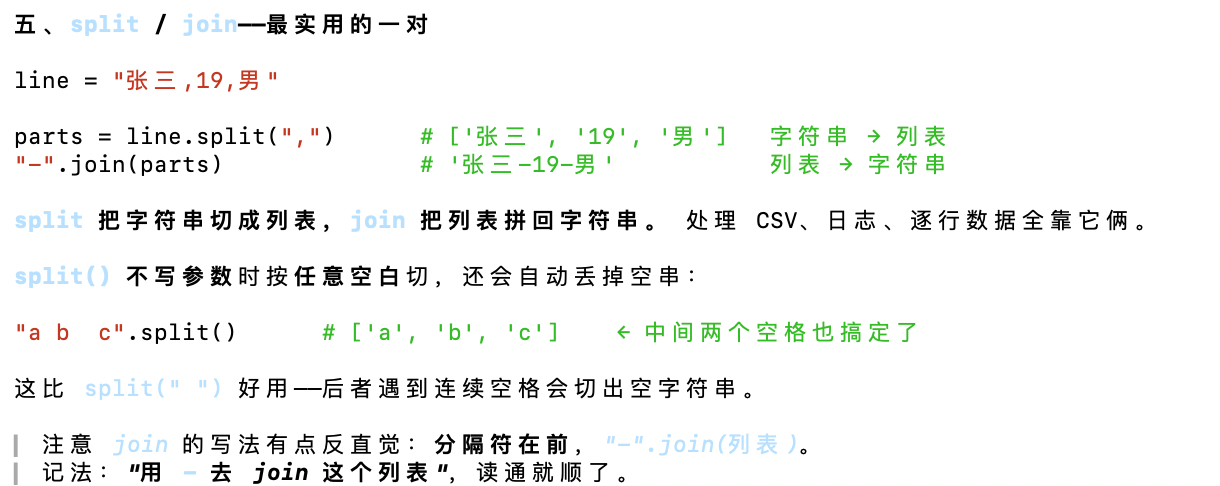
- 切字符:
- 按分隔符切:split()最常用
1 | s = "a,b,c,123" |
split(sep,maxsplit)限制切几次
1 | s = "one two three four" |
- 从右切:rsplit():
1 | s = "one two three four" |
- 按行切splitlines():
把多行字符串按换行\n切开
1 | txt = "第一行\n第二行\n第三行" |
- 切片截取(按位置去一段字符,不是分割成列表):
格式:字符串[起始:结束:步长]:左开右闭,结束下标不取
1 | s = "abcdef" |
- 取单个字符下标:
1 | s = "abcdef" |
- 区分:split:按符号切成多个字符串,得到列表(拆分句子)
[a:b]:按位置截取一段子串(抠一段文字)
from math import *:*代表全部东西,直接写 pi、sin、log!- 第 1 个 if 成立,打印沪市 A 股
后面所有 if 都不成立,最后一个 if 不成立,触发它的 else,额外打印:错误编码
👉 结果会输出两行 - 文件读写
哔哩哔哩课程
基础
内存就相当于是仓库,赋值时变量就相当于c语言中的指针,只保存了对象的地址(对象存在于仓库中)。
- 赋值和深浅拷贝
- 函数与return
- return返回值(若超过1个值,则返回元组)给调用者
- return表示函数结束
- return与print:
- 形参与实参:定义函数时里里面的值,实参调用函数时里面的具体的值
- 必备参数:传递和定义参数的顺序集个数必须一致,def(a,b),写了几个要传几个
- 默认参数:为参数提供默认值,调用函数时可以不传该默认值的值,fanc(a = 8),⚠️所有位置参数必须出现在默认参数前,包括函数定义和调用(b,a = 8)
- 可变参数:传入值得数量可以改变,可以传入多个,也可以不传,,def func(*args),以元组形式返回
- 关键字参数:def fund(**kwargs),以字典形式返回{a = 1,b = 2},key = value,可以扩展函数的功能
- 函数嵌套:在一个函数中调用另一个函数
- 作用域:指的是变量生效范围,有局部变量和全局变量
全局变量:函数外部定义的变量,在整个文件中都有效,局部变量反之,函数结束时失效
global全局变量,将局部变量变成全局变量 - 匿名函数:函数名 = lambda(关键字) 形参;返回值(表达式),无需return返回值,表达式本身就是返回。add = lambda a,b:a+b
- lambda的参数形式:无参,一个,默认
- lambda结合if判断:comp = lambda a,b:”a>b”if a>b else “a<=b>”
- 内置函数:
- 查看所有内置函数import builtins–>print(dir(builtins))
- 常用内置函数
abs():返回绝对值sum():求和,里面只能是可迭代对象min():求最小值max():求最大值zip():将可迭代对象中对应的元素打包成元组1
2
3
4
5
6li = [1, 2, 3]
li2 = ['a', 'b', 'c']
print(zip(li, li2))
for i in zip(li, li2):
print(i)
print(type(i))输出:
1
2
3
4<zip object at 0x...>
(1, 'a')
<class 'tuple'>
...map():可以对可迭代对象中的每一个元素进行映射,分别去执行,简单来说就是将每一个元素都遍历一遍
1
2
3
4li = [1,2,3]
def funa(x):
return x * 2
print(list(map(funa, li)))#[2, 4, 6]reduce():先把对象中的两个元素去除,计算出其中一个值然后保存着,接下来把这个计算值跟第三个元素进行计算,需要先导包
1
2
3
4
5
6from functools import reduce
# reduce(function, sequence)函数会对参数序列中元素进行累积,function必须接收两个参数,sequence是序列:可迭代对象。
li = [1,2,3,4]
def funb(x,y):
return x + y
print(reduce(funb, li)) # 10 - 拆包:对于函数中的多个返回数据,去掉元组,列或者字典直接获取里面数据的过程。
1 | tua = (1,2,3,4) |
- 异常:
- 抛出异常raise:
- try and except:用来捕获代码运行时的错误,不让程序直接崩溃终止。1. 先运行
try里面所有代码;
✅ 如果没有报错:except里面代码不执行,直接跳过; ❌ 如果出现异常:立刻停止 try 里代码,跳到except执行1
2
3
4
5
6
7
8
9
10def login():
pwd = input("请输入密码:")
if len(pwd) >= 6:
return '登录成功'
raise Exception("密码长度不能小于6位")
# print(login())
try: #捕获异常
print(login())
except Exception as e:
print(e) #捕获异常是为了防止程序崩溃,打印异常信息,让程序继续执行下去
模块:一个py文件就是一个模快,即倒入一个模块本质上就是执行一个py文件
- 内置模块:例如random,time,os,login,直接导入皆可使用
- 第三方模块:下载:终端输入pip install 模块名(pip install 是 Python 的“安装包”命令。)
- 自定义模块:自己在项目里定义的模块。注意啊;命名要遵循规则。不要与内置模块起冲突,否则会导致模块功能无法使用
导入模块:
import 模块名
调用模块功能:模块.功能名
1
2
3
4
5
6
7
8
9
10
11#方式一:import 模块名;注意一个import可以导入多个模块,但最好一个模块单独使用一个import
# import pytext
# #调用pytext中的name变量
# print(pytext.name)
# #调用pytext模块中的funa函数
# pytext.funa()
#方式二:from ...import...
#语法:from 模块名 import 功能1,功能2...;从模块中导入指定的功能
from pytext import funa
funa() #直接输入功能即可,不用再添加模块了
#方式三:from ... import *(代表所有)#不建议过多使用from ... import ,有时候命名冲突会导致出现一些错误给模块起别名:import 模块 as 别名
给功能起别名:from 模块名 from 功能名 as 别名,另一个功能名 as 别名(多个功能用逗号隔开)- 内置全局量:
__name__:用于控制py文件在不同场景执行不同的逻辑
-if __name__ =="__mian__":文件在当前程序执行()自己执行自己,被当作模块导入是,下面的内容不会被显示__name__== 模块名:文件被当作模块被其他文件导入1
2
3
4
5
6
7
8
9import pytext2
pytext2.text()
###
print("这是pytext2作为模块会显示的内容")
def text():
print("哈哈哈")
if __name__ == "__main__":
print("这是pytext2作为模块不会显示的内容")
###
- 包:就是项目结构中的文件夹/目录
- 与普通文件夹的区别:包是含有
__init__.py的文件夹(不建议在__init__.py文件中写大量代码) - 作用:联系的模块放到同一文件夹下,有效避免模块名冲突问题,任结构更清晰
- 新建包:右键项目名–>new–>python package建有联系的模块放到同一文件夹下,有效避免模块名冲突问题,任结构更清晰
1
2
3
4
5
6#导包方式一:
# import pack_01 #import导入包是首先会执行__init__.py文件
#这是在模块里__init__.py文件
# #导包方式二:
# from pack_01 import register
# register.reg()1
2
3
4
5
6
7
8print("这是register.py文件")
def reg():
print("nb")
###
这是在模块里__init__.py文件
这是register.py文件
nb
###__all__:本质上是一个列表,列表里的元素就代表要导入的模块- 作用:可以控制要引入的东西
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23register.py
print("这是register.py文件")
def reg():
print("nb")
logon.py
print("这是一个登录文件")
def logon():
print("666")
__init__.py
__all__ = ["register",'logon']#相当于导入[]中的模块
pytext.py
from pack_01 import *
register.reg()
logon.logon()
###
这是register.py文件
这是一个登录文件
nb
666
###- 包的本质依旧是模块,包又可以含包
- 与普通文件夹的区别:包是含有
- 递归函数:一个函数在函数内部不掉用其他函数,而是调用自己
条件:
必须有一个明确的结束条件 –递归出口
每进行更深一层的递归,问题规模相比上次递归要有所减少
相邻两次重复之间有紧密联系
很简洁,逻辑清晰;使用递归函数时,消耗内存,慢 - 闭包:在嵌套函数的前提下,内部函数使用了外部函数的变量,而且外部函数返回了内部函数,我们把使用了外部函数的内部函数称为闭包
条件:
- 函数嵌套(函数里面再定义函数)
- 内层呢函数使用外层函数的局部变量
- 外层函数返回值是内层函数的函数名
1 | def out():#外层函数 |
1 | def out(m):#外函数,m是形参,也是外函数的局部变量 |
函数引用:先思考一下,我们在函数里用到a = 1时,我们知道a这个变量只是存(我们也可以说是引用)了1这个对象的地址,并不是等于a,所以得def add(),中的add这个函数名我们其实可以说里面存了函数的地址,所以我们可以通过引用调用函数
1 | def outer(x): |
- 装饰器:本质上就是一个闭包函数,更多是用于后期升级而不是去编写更多代码,可以让函数在不需要做任何代码的变动下增加额外功能
- 不修改原程序或函数的代码
- 不改变函数或程序的调用方法
1
2
3
4
5
6
7
8
9
10
11
12
13
14#标准语法
#被装饰的函数
def send():
print("发送消息")
#装饰器函数
def out(fn):
print("登录")
def inner():
#执行被装饰地函数
fn()
return inner
ot = out(send)
ot()
#装饰器的原理就是将原有的函数名重新定义为原函数为参数的闭包1
2
3
4
5
6
7
8
9
10#语法糖:@out 是 send = out(send) 的简写
def out(fn):
print("登录")
def inner():
fn()
return inner
@out
def send():
print("发送消息:哈哈哈")
send()
==闭包是“函数套函数,并且内层记住了外层的变量”;装饰器是“接收一个函数,返回一个包装过的新函数”;导入模块则是“直接复用别人写好的函数“==
进阶-面向过程和对象
- 面向过程(手洗):需要实现一个功能的时候看中的是过程,分析出一个个步骤,并把一个个步骤用一个个函数实现(每一个步骤都要自己亲力亲为)
面向对象(机洗):需要实现一个功能的时候,着重的是谁帮我去做这件事(偷懒,找别人帮我做)
类:对一系列具有同属性和行为的事物的统称,是一个抽象的概念,不是真实存在的事物格式:class类名:#类名必须符合标识符规定同时遵循大驼峰命名法,见名知意
代码块
1 | class Washer: |
三要素:
- 类名
- 属性:对象的特征描述,用来说明是什么样子
- 方法:对象具有的功能(行为),用来说明能做什么
对象:类的具体表现,是类创建出来的真实存在的面向对象的思想核心
创建对象的过程也叫做实例化对象
实例化对象的基本格式:对象名=类名()
实例方法和实例属性实例方法:
- 有对象调用,至少有一个self参数[^self参数],执行实例方法的时候,自动将调用该方法的对象赋值给self
1 | class Washer: |
实例属性
与类属性的区别:类属性属于类,是公共的,大家都能访问到,实例属性属于对象,是私有的,只能由对象访问,不能由类名访问
格式:self.属性名
1 | class Person: |
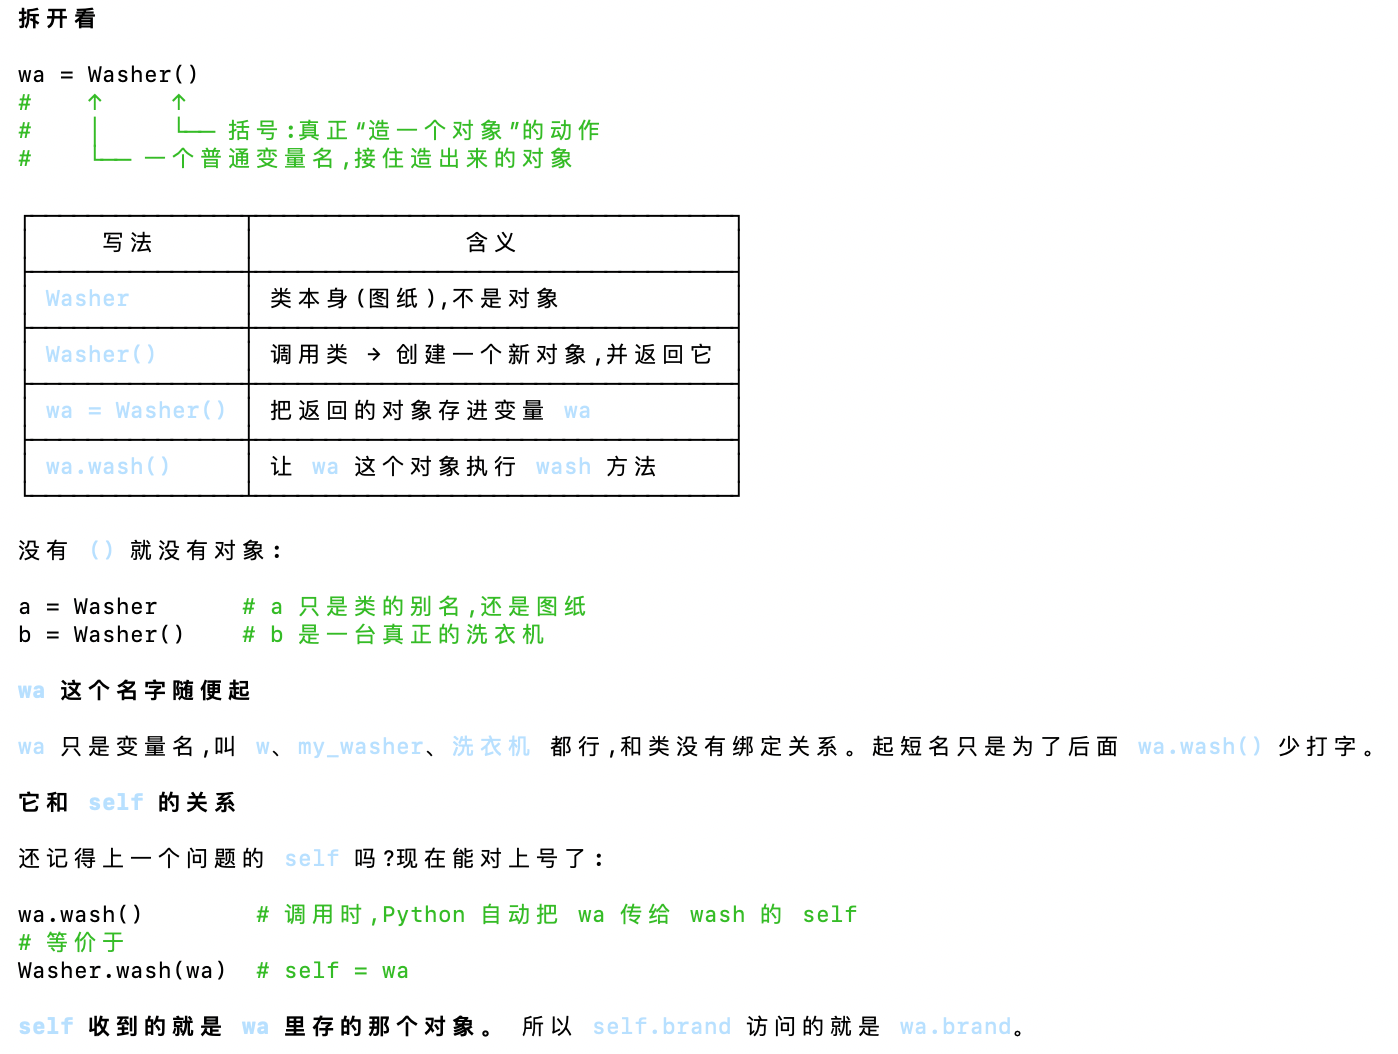
[^self参数]:self 代表“当前这个对象自己”
- 构造函数
__init__()- 作用:通常用来做属性初始化或者赋值操作
- 注意:在类实例化对象的时候,会被自动调用
1 | # #构造函数__init__() |
- 析构函数
__del__():删除对象的时候,解释器会默认用__del__()方法
1 | #析构函数__del__(),主要是表示该程序块或者函数已经全部执行结束 |
- 面向对象的三大特性:封装、继承、多态
封装:指的是隐藏对象中一些不希望被外部访问到的属性或方法(前面有两个下划线)
1 | class Person: |
私有属性/方法
- XXX:普通属性/方法,如果定义在类中,则类可以在任意地方使用
- -XXX:单下滑线开头,声明私有属性或方法,如果定义在类中,子类也可以继承,但是通过import *导入时,无法导入,一般是为了避免与python关键字冲突而采用的命名方法
- __XXX:双下划线开头,隐藏属性,无法在外部直接访问,子类不会继承,要访问只能通过间接的方式,另一py文件中通过from XXX import * 导入的时候,也无法导入,这一种命名一般是python中的魔法方法或属性,都是有特殊含义或者功能的,自己不要轻易定义
1 | class Person: |
1 | class Man: |
- 继承:让类和类之间转变为父子关系,之类默认继承父类的属性和方法
语法
class 类名(父类名):
#代码块
单继承
1 | class Person: |
继承的传递(多重继承)
A/B/C c(子类)继承于B(父类),B(子类)继承于A(父类),C类具有A/B的属性和方法
1 | class Father: |
方法的重写:在子类中定义与父类相同名称的方法
覆盖父类的方法:
1 | class Person: |
对弗雷德方法进行扩展:继承父类的方法,子类也可以增加自己的功能
1 | 1.父类名.方法名(self) |
1 | 2.super().方法名()---推荐,super()是使用super类创建出来的对象,可以调用父类中的方法 |
1 | 3.super(子类名,self).方法名() |
新式类写法:
1 | #class A:#经典类:不由任意内置类型派生出来的类 |
- 多继承
1.子类可以拥有多个父类,并且具有所有父类的属性和方法
1 | class Father(object):#和class Father():,没有区别,在python3中默认所有类默认就继承 object |
2.不同的父类具有相同的方法
1 | class Father(object):#和class Father():,没有区别,在python3中默认所有类默认就继承 object |
3.方法的搜索顺序(了解即可):python中内置的属性__mro__可以查看搜索顺序
1 | print(Child.__mro__) |
4.多继承的弊端:1.容易引发冲突2.会导致代码设计的复杂度增加
- 多态:指同一种行为具有不同的表现形式
1.前提:继承,重写
2.多态性:一种调用方法,不同的执行结果
1 | class Animal(): |
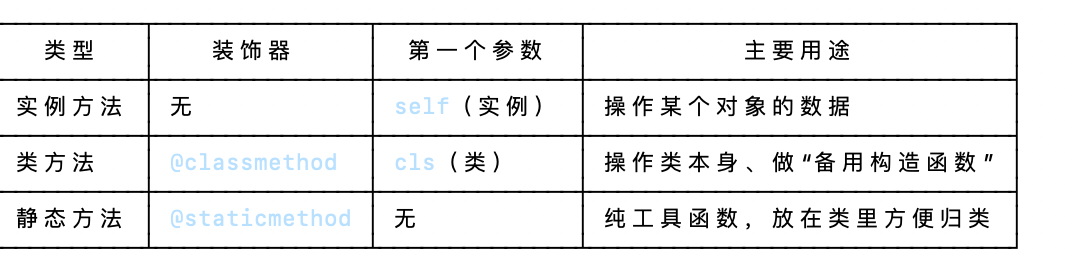
- 静态方法:使用@staticmethod来进行修饰,静态方法没有self,cls参数的限制,与类无关,可以转化成函数使用
1 | class Person: |
*类方法:使用装饰器@classmethod来标识为类方法,第一个参数必须是类对象,一般是以cls作为第一个参数
1 | class Person: |
- 总结:
- init()和__new__()
“重写”的前提
重写(override)= 子类定义了和父类同名的方法。
- 有父类、父类有同名方法 → 才叫重写,super() 可以调用父类版本。
- 没有父类方法 → 你只是定义了一个新方法,不叫重写,super() 也没有东西可调。
单例模式:可以理解成一个特殊的类,这个类只存在一个对象,可以节省内存空间,减少了不必要的资源浪费,多线程访问是会引发线程安全问题
方式
1.通过@classmethod
1 | class Singleton: |
2.通过装饰器实现
1 | import functools |
3.通过重写__new__()来实现(重点)
设计流程
1.定义一个类属性,他的初始值为None,用来记录单;例对象的引用
2.重写__new__()方法
3.进行判断,如果类属性是None,把__new__()返回的对象保存进去
4.返回类属性中对象的引用
1 | #单例模式,每次实例化所创建的对象都是同一个 |
4.通过导入模块实现:模块就是天然的单例模式
1 | from pytext import te as te01 |
- 应用场景:
回收站对象
音乐播放器,一个音乐播放器负责音乐播放的对象只有一个
开发游戏软件,场景管理器
数据库配置,数据库连接池的设计 - 魔法方法:XX()的函数就叫做魔法方法,具有特殊功能的函数
1.
__doc__():类的描述信息
1 | """ 人类---类,函数的描述信息"""#只能用多行注释 |
2.
__moudle__():表示当前操作对象所在的模块
3.__class__():表示当前操作对象所在的类
4.__str__():对象的描述信息,如果类中定义了此方法,那么在打印对象时,默认输出该方法的返回值,也就是打印方法中return的数据,他必须返回一个字符串
1 | class C: |
5.
__del__():析构函数,在程序结束时会调用,或者删除摸个对象的时候会被调用
6.__call__():是一个实例对象成为一个可调用对象(函数,内置函数和类都是,凡事可以把一对()引用到某个对象身上都可以称之为可调用对象),就像函数那样可以调用
1 | class A: |
- 文件的基础操作
文件就是储存在某种长期储存设备上的一段数据
文件操作:打开文件–》读写文件–关闭文件
文件对象方法:open():创建一个file对象,默认是一只读模式打开
read(n):n表示从文件中读取的数据长度,没有传n值或者是负值就默认一次性读取文件的所有内容
readline():一次只读取一行内容,方法执行完,会把文件指针移到下一行,准备再次读取
readlines():按照行的方式把文件内容一次性读取,返回的是一个列表,每一行的数据就是列表中的一个数据
write():将指定内容写入文件
close():关闭文件
属性:- 文件名.name:返回要打开的文件名,可以包含文件的具体路径
- 文件名.mode:返回文件的访问方式
- 文件名.closed:检测文件是否关闭,关闭就返回true
访问模式
文件指针:标记从哪里开始读取数据
文件定位操作tell():显示文件当前位置,即文件指针当前位置
seek(offset,whence):移动文件读取指针到指定位置;offset:偏移量,表示要移动的字节数,whence:起始位置,表示移动字节的参考位置,默认是0,0代表文件开头作为参考位置,1代表当前位置作为参考位置,2代表将文件结尾作为参考位置
seek(0,0):会把文件指针移到文件开头
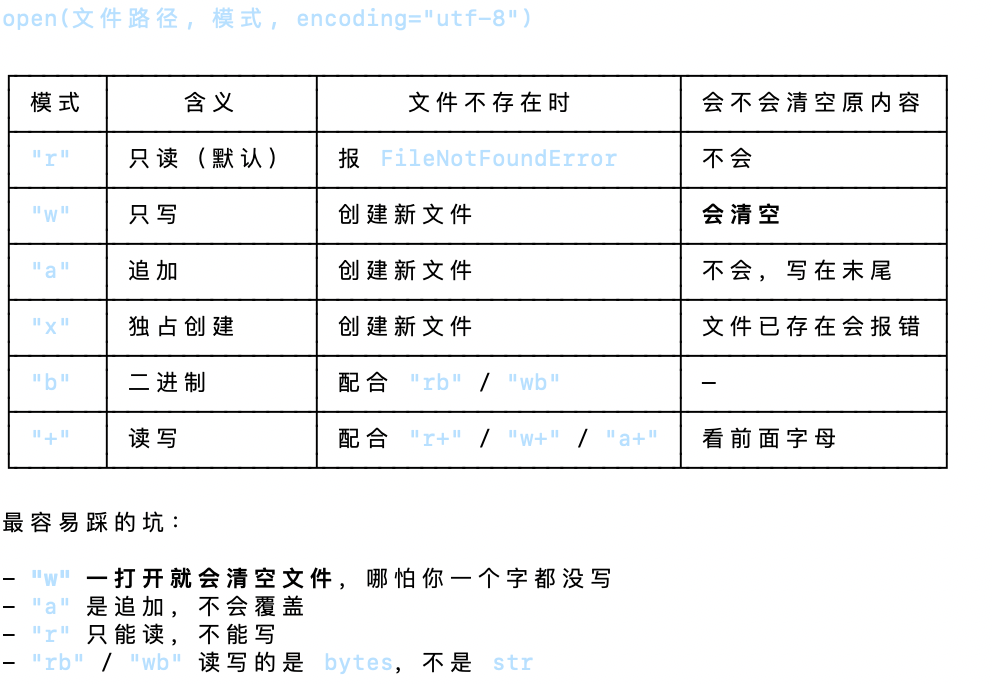
1 | f = open("text.txt","w+")#先写再读 |
- with open:代码执行完,系统自动调用f.close(),可以忽略文件关闭步骤
1 | with open("text.txt","w+") as f:#f是文件对象 |
1 | with open('/Users/luochangli/Pictures/图库原图备份/樱色祢豆子.jpeg','rb') as f: |
- 目录常用操作:
导入模块:import os
- 文件重命名os.rename(‘旧名字’,’新名字’)
- 删除文件 os.remove(‘文件名’)
- 创建文件夹os.mkdir(‘文件夹名’)
- 删除文件夹os.rmdir(‘文件夹名’)
- 获取当前目录os.getcwd()
- 获取目录列表os.listdir()
- 获取上一级目录列表os.listdir(“../”)
- 迭代器